Định nghĩa chung về Pacemaker
Định nghĩa chung về Pacemaker, đây là bài viết dễ tiếp cận và dễ hiểu nhất cho những ai mới bắt đầu nghiên cứu
I. Định nghĩa
1. Pacemaker: là trình quản lý tài nguyên trong cluster, được phát triển cho phép tùy biến, hỗ trợ tối đa để các tài nguyên (resource) thuộc cluster luôn đảm bảo tính sẵn sàng. Đồng thời pacemaker có khả năng phát hiện phục hồi các tài nguyên, các node đang xảy ra sự cố thông qua các engine hỗ trợ (Corosync, Heartbeat), cho phép tùy biến tùy theo các kiến trúc cluster khác nhau.
2. Các tính năng chính của Pacemaker:
3. Kiến trúc của pacemaker.
– Low-level infrastructure: Các project như Corosync, CMAN, Heartbeat cung cấp các tin nhắn tin cậy về thông tin về tài nguyên, node, quorum của cụm tới pacemaker.
– Quản lý tài nguyên (Resource management): Pacemaker cung cấp trung tâm giám sát, phản ứng với các sự kiện xảy ra trong cluser. Các event có thể là các node bị loại bỏ, tham gia vào cụm, các hoạt động bảo trì, các thao tác quản trị cơ bản. Pacemaker sẽ nhận thức, tự động đánh giá trạng thái lý tưởng cho cụm ra chỉ thị cho cụm trở lại trạng thái lý tưởng (tự động di chuyển tài nguyên, loại bỏ thành phần lỗi bằng các tắt dịch vụ hoặc tắt hẳn node).
– Các thành phần cluster không thể nhận biết (Non-cluster-aware components): Các thành phần được script hóa để có thể thực hiện các hành động tắt, bật, giám sát.
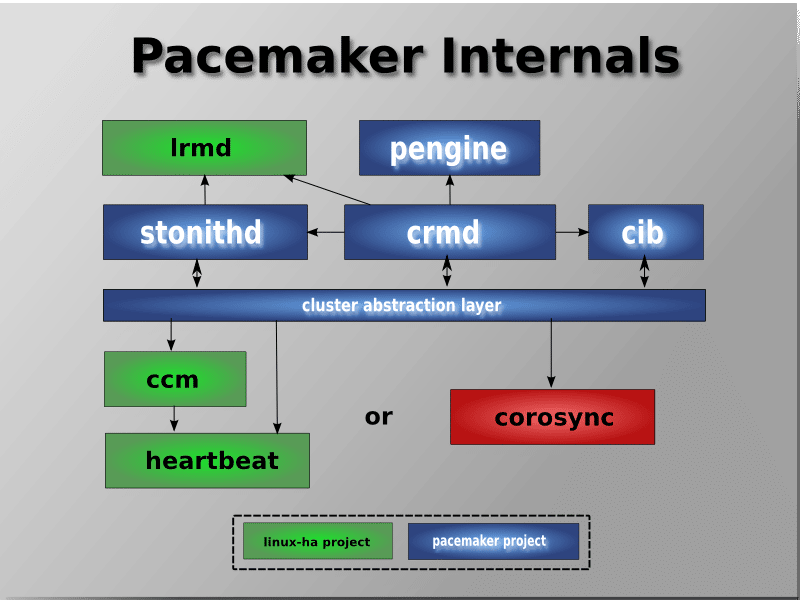
4. Các thành phần nội tại Pacemaker.
– Pacemaker chia thành 5 thành phần chính:
4.1. Cluster Information Base (CIB): CIB được viết dưới dạng XML để thể hiện cấu hình cluster cũng như trạng thái hiện tại của các tài nguyên bên trong cluster. Nội dung của CIB tự động đồng bộ tới tất cả các node trên toàn cluster, đồng thời sử dụng PEngine (Chịu trách nhiệm về việc bắt đầu thay đổi trạng thái trong cluster) để đánh gía trạng thái lý tưởng của Cluster và cách để đạt trạng thái lý tưởng.
* CIB bao gồm làm 2 phần là configuration và status.
* Trong mục configuration sẽ có 3 phần khác:
* crm_config
* node: Hiển thị các node
* resouces: Các resource đc định nghĩa để cluster quản lý.
**resouces là gì?
Để tạo một resource, chúng ta cần phải có các resource agents (RAs). Một resource agent là một script mà cluster sử dụng để start, stop và monitor resource. Nó giống như một kịch bản dùng để load dịch vụ được sử dụng trong System-V runlevels, có thể so sánh với systemctl và được điều chỉnh riêng để nó sử dụng trong cluster. Đối với 1 admin, nó rất quan trọng để biết được thuộc tính nào có thể sử dụng trước khi bắt đầu cấu hình resources. RAs được cài đặt cùng với cluster và chia ra thành các lớp khác nhau như sau:
– LSB: LSB (Linux Standard Base) resource agents là một kịch bản khởi động System-V runlevels có thể khởi động từ cluster. Được cài đặt cùng với OS.
– OCF: OCF (Open Cluster Framework) resource agents không giống như lsb resource agents có các tham số đặc biệt liên quan đến cluster bao gồm các tính chất thường được lưu trữ trong file cấu hình. Giữa ocf và lsb thì ta nên chọn ocf resource agents. Trong ocf resource agents chia ra thành các lớp “provider” như sau:
* heartbeat
* linbit
* lvm2
* ocfs2
* pacemaker
* service: Được quản lý bởi system daemon (systemd) của hệ thống. Tránh sử dụng nếu một ocf thay thế đang tồn tại
* stonith: Một resource agent dùng cho cơ chế STONIT
* Cách liệt kê về các resource hiện có trên hệ thống
* Liệt kê ra các resource agents đi kèm cùng với cài đặt:
pcs resource standards
* Liệt kê ra các lớp provider trong ocf resource agents:
pcs resource providers
* Liệt kê ra các lựa chọn được cung cấp bởi standards resource và provider:
pcs resource agents standards:providers
ví dụ:
pcs resource agents ocf:heartbeat
4.2. Cluster Resource Management Daemon (CRMd): Các thao tác tới tài nguyên thuộc Cluster được định tuyến thông qua tiến trình này. Tiến trình cho phép truy vấn thông tin, di chuyển, khởi tạo, thay đổi trạng thái khi cần. Node là master crmd thực sự hoạt động được công nhận là designated coordinator (DC). Nếu DC fail, cluster sẽ tự động chọn một DC mới rất nhanh chóng.
4.3. Local Resource Management daemon (LRMd): tiến trình này đc chạy trên mỗi node thuộc cluster, tiến trình này như giao diện giữa CRMd với các tài nguyên nội tại của node. Tiến trình LRMd sẽ chuyển chỉ thị từ CRMd tới các thành phần tài nguyên nó quản lý.
4.4. Policy Engine (PEngine): Chịu tránh nhiệm tính toán trạng thái lý tưởng của cụm, ra chỉ thị, kịch bản cho CRMd để hiện thực hóa trạng thái mong muốn., Cách tốt nhất để 1 admin tác động tới hành vi của pengine là đinh nghĩa những hạn chế trong cluster.
4.5. Shoot the Other Node in the Head (STONITH): Giải pháp cho các node cứng đầu không phản hồi, không nhận chỉ thị mềm, CRMd sẽ chỉ thị cho STONITH tắt nóng, hoặc khởi động lại trực tiếp thông qua phần cứng (IPMI, IDRAC, ILO, ..), * Nếu 1 node không trả lời, membership layer (corosync) sẽ nói cho crmd biết và crmd hướng dẫn stonith chấm dứt node đó.
5. Sự kiện trong pacemaker:
###Split Brain
**một trường hợp mà cluster được tách thành nhiều phần. Nhưng mỗi phần lại tiếp tục hoạt động như những cluster riêng biệt, có khả năng ghi vào cùng một dữ liệu làm duplicate dữ liệu .Nếu tài nguyên là file system và multi nodes cố gắng ghi file system đồng thời và không có sự phối hợp. Nó có thể dẫn tới corruption của file system và mất dữ liệu.
###quorum:
* Để duy trì tính toàn vẹn và sẵn có của cluster, các hệ thống cluster sử dụng khái niệm này để ngắn ngừa sự mất mát dữ liệu. Một cluster có quorum khi có hơn một nửa số lượng các node đang có trạng thái online. Để giảm thiểu nguy cơ mất mát dữ liệu, mặc định pacemaker sẽ ngừng tất cả các resource nếu cluster không có quorum
* quorum được hình thành bằng các sử dụng voting system khi mà một node trong cluster không hoạt động như mong muốn hoặc mất liên lạc với phần còn lại của cluster, các node còn lại trong cluster có thể thực hiện vote để cô lập và nếu cần thiết thì loại bỏ node đang bị lỗi, … này ra khỏi cluster
* Trong trường hợp mà số lượng các node khả dụng và không khả dụng bằng nhau quorum có thể được cấu hình để có chính sách tiebreaker để tiếp tục quorum và duy trì các node trong cluster còn lại và dành quorum cho node mà có id thấp nhất.
* quorum chấp nhận 4 giá trị được cấu hình tương ứng với 4 hành động sau khi cluster xảy ra lỗi:
* ignore: Tiếp tục quản lý tất cả các tài nguyên
* freeze: Tiếp tục quản lý tất cả các tài nguyên, nhưng không phục hồi tài nguyên từ node lỗi
* stop: Dừng tất cả các resource trong vùng ảnh hưởng.
* suicide: Lập rào cản tất cả các node trong vùng có cluster bị ảnh hưởng
###Để giải quyết split brain người ta sử dụng quorum hoặc fencing/stonith
* Quá trình đàm phán Quorum: xảy ra khi một node đang sở hữu một quorum resource bị lỗi hay không hoạt động, và các node còn lại sẽ xác định node nào sẽ giữ quyền sở hữu quorum resource. Mục đích của quá trình đàm phán quorum là tại một thời điểm đảm bảo rằng chỉ một node duy nhất được sở hữu quorum resource. Việc chỉ cho một node sở hữu quorum resource là rất quan trọng bởi vì nếu tất cả các giao tiếp giữa 2 hay nhiều node bị lỗi, nó có khả năng chia Cluster thành 2 hay nhiều phần riêng biệt để giữ cho nó vần tiếp tục hoạt động (split brain). Server Cluster ngăn ngừa nó bằng cách chỉ cho phép duy nhất một Cluster tách ra này có chứa node đang sở hữu quorum resource tiếp tục hoạt động như một Cluster. Bất kỳ node nào không thể giao tiếp với node đang sở hữu quorum resource, thì node đó sẽ không còn là node thành viên trong Cluster.
* fencing/stonith
Lý do cần dùng đến cơ chế STONITH:
* Giả sử trong một cluster có một node A bị lỗi. Node A sẽ được khởi động lại và được thêm lại vào cluster một lần nữa. Điều này có vẻ đã được khắc phục lỗi. Nhưng nếu đây là một lỗi quan trọng và ngay sau khi khởi động lại node A. Node A vẫn gặp lại lỗi đó và lại được khởi động lại, điều này cứ lặp đi lặp lại như thế nhưng lỗi thì vẫn cứ lỗi. STONITH rất cần thiết trong trường hợp này và chúng ta cần cấu hình cho phép tắt node A này đi để ngăn việc node A cứ khởi động lại như vậy.
* Fencing là gì?
* Trong một hệ thống cluster, có thể có nhiều node làm việc cùng sử dụng chung một phần dữ liệu quan trọng. Khi mà các node trong cluster rơi vào trạng thái không khả dụng, đa số các node còn lại trong cluster bắt đầu trở lên thất thường hoặc trở lên không hoạt động dẫn đến cần có các hành động thủ công của người quản trị viên. Các vấn đề gây ra bởi các node trong cluster có thể được giảm nhẹ bằng việc thiết lập một chính sách fencing.
6. Các mô hình triển khai pacemaker
- Pacemaker không có giới hạn về cách triển khai của bạn, chính điều này mà nó cho phép ta có thể triển khai theo hầu hết các mô hình như:
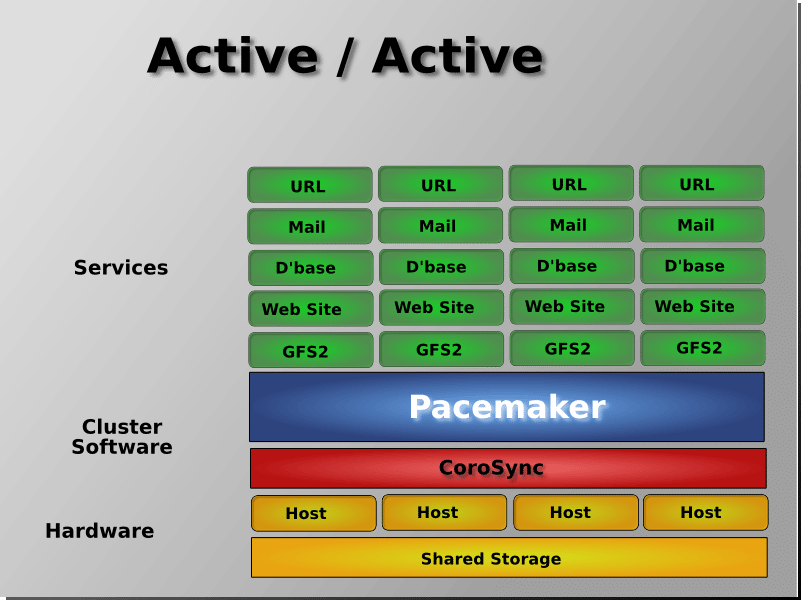
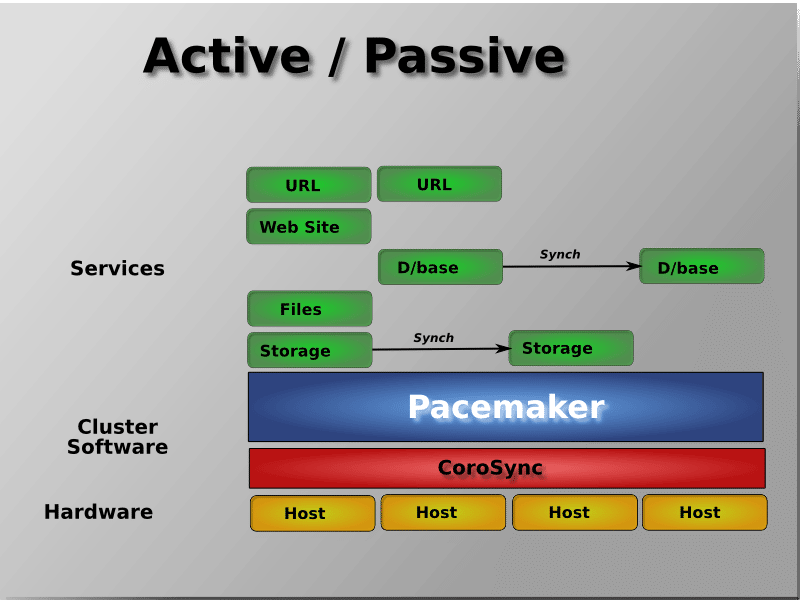
* Active/ Active * Active/ Passive * N + 1 * N + M * N to 1 * N to M
- Dưới đây là một vài mô hình triển khai:
* Active / Passive
* Active / Active